
Table I.
SYMBOLIC DESCRIPTION
| symbol | means |
| DB | raw data set |
| db | new data set |
| DBUdb | all data sets |
| Lk | frequent item sets(k-order) |
| Ck | candidate set(k-order) |
Table II.
HORIZONTAL DATABASE
| TID | Item |
|---|---|
| 1 | citrus fruit, yogurt, butter, ham |
| 2 | tropical fruit, yogurt, coffee |
| 3 | whole milk, citrus fruit, newspapers |
| 4 | tropical fruit, yogurt, cream cheese, whole milk |
| 5 | coffee, butter, yogurt, sauces, ham |
| 6 | butter, ham, cream cheese, sauces, newspapers |
Table III.
VERTICAL DATABASE
| Item | TID |
|---|---|
| butter | 1,5,6 |
| citrus fruit | 1,3 |
| coffee | 2,5 |
| cream cheese | 4,6 |
| ham | 1,5,6 |
| newspapers | 3,6 |
| sauces | 5,6 |
| tropical fruit | 2,4 |
| whole milk | 3,4 |
| yogurt | 1,2,4,5 |
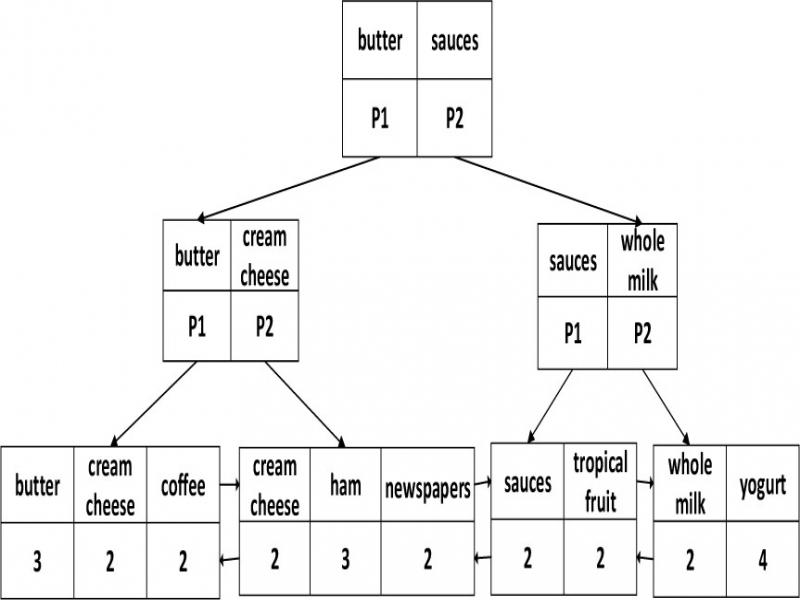
Figure 1.
Order three of the B+ tree
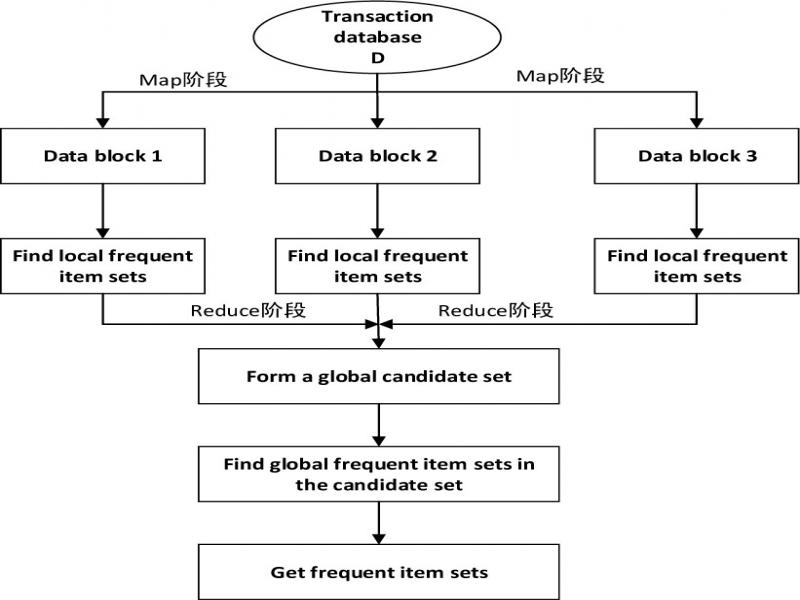
Figure 2.
Frequent item set generation step diagram
Table IV.
RULE SUPPORT AND CONFIDENCE CALCULATION RESULTS
| CD\RD | ham | bread | coffee |
|---|---|---|---|
| butter | (0.4,0.55) | (0.13,0.28) | (0.2,0.3) |
| yogurt | (0.36,0.54) | (0.63,0.58) | (0.26,0.39) |
| cheese | (0.43,0.51) | (0.3,0.53) | (0.31,0.52) |
Table V.
DIFFERENCE QUOTIENT TABLE
| Number of rules (nk) | xk | f(xk | First order difference quotient | Second order difference quotient |
|---|---|---|---|---|
| 1 | 0.0625 | 0.6 | ||
| 4 | 0.25 | 0.4 | -1.07 | |
| 7 | 0.4375 | 0.3 | -0.53 | 1.44 |
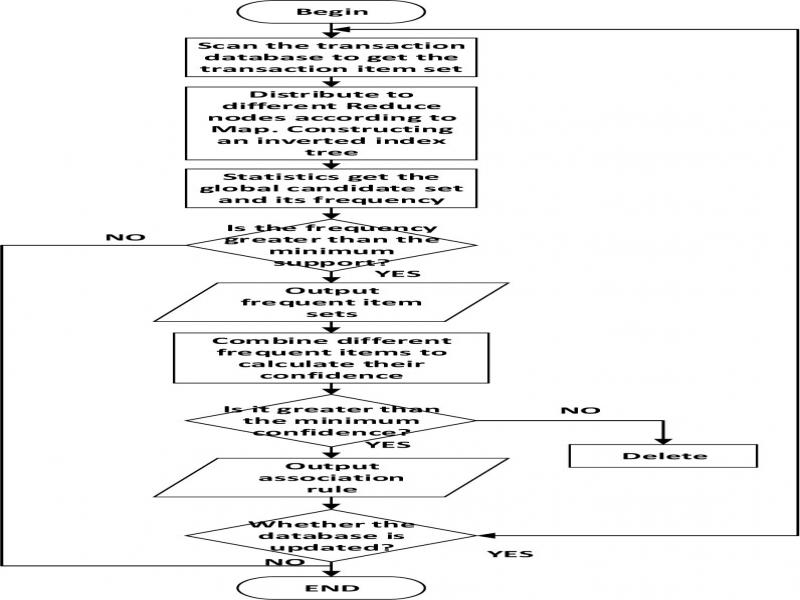
Figure 3.
HBPT-FUP algorithm step diagram
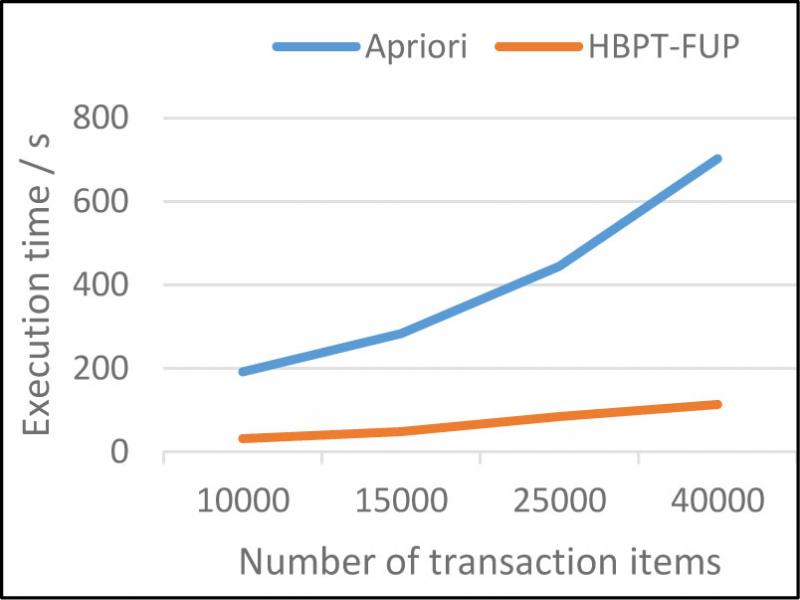
Figure 4.
Apriori and HBPT-FUP algorithms time comparison
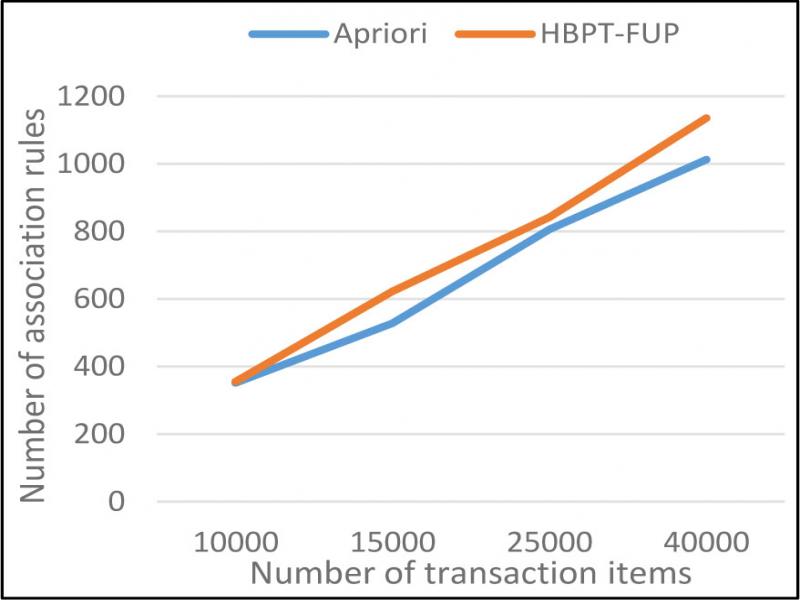
Figure 5.
Comparison of the number of association rules
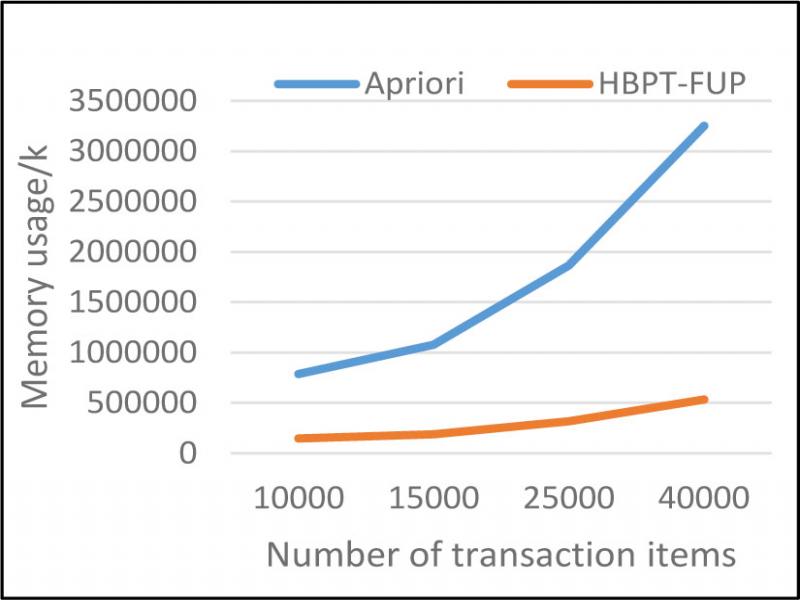
Figure 6.
Memory usage comparison
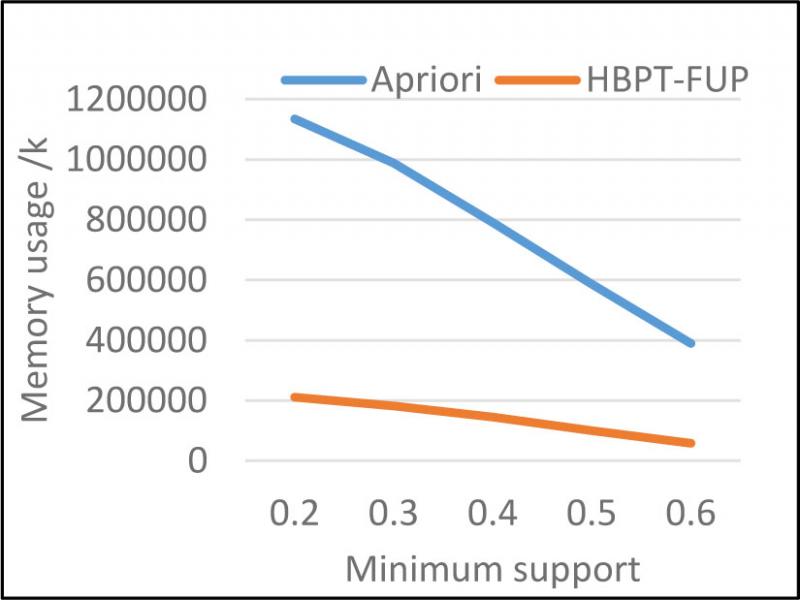
Figure 7.
Memory usage comparison